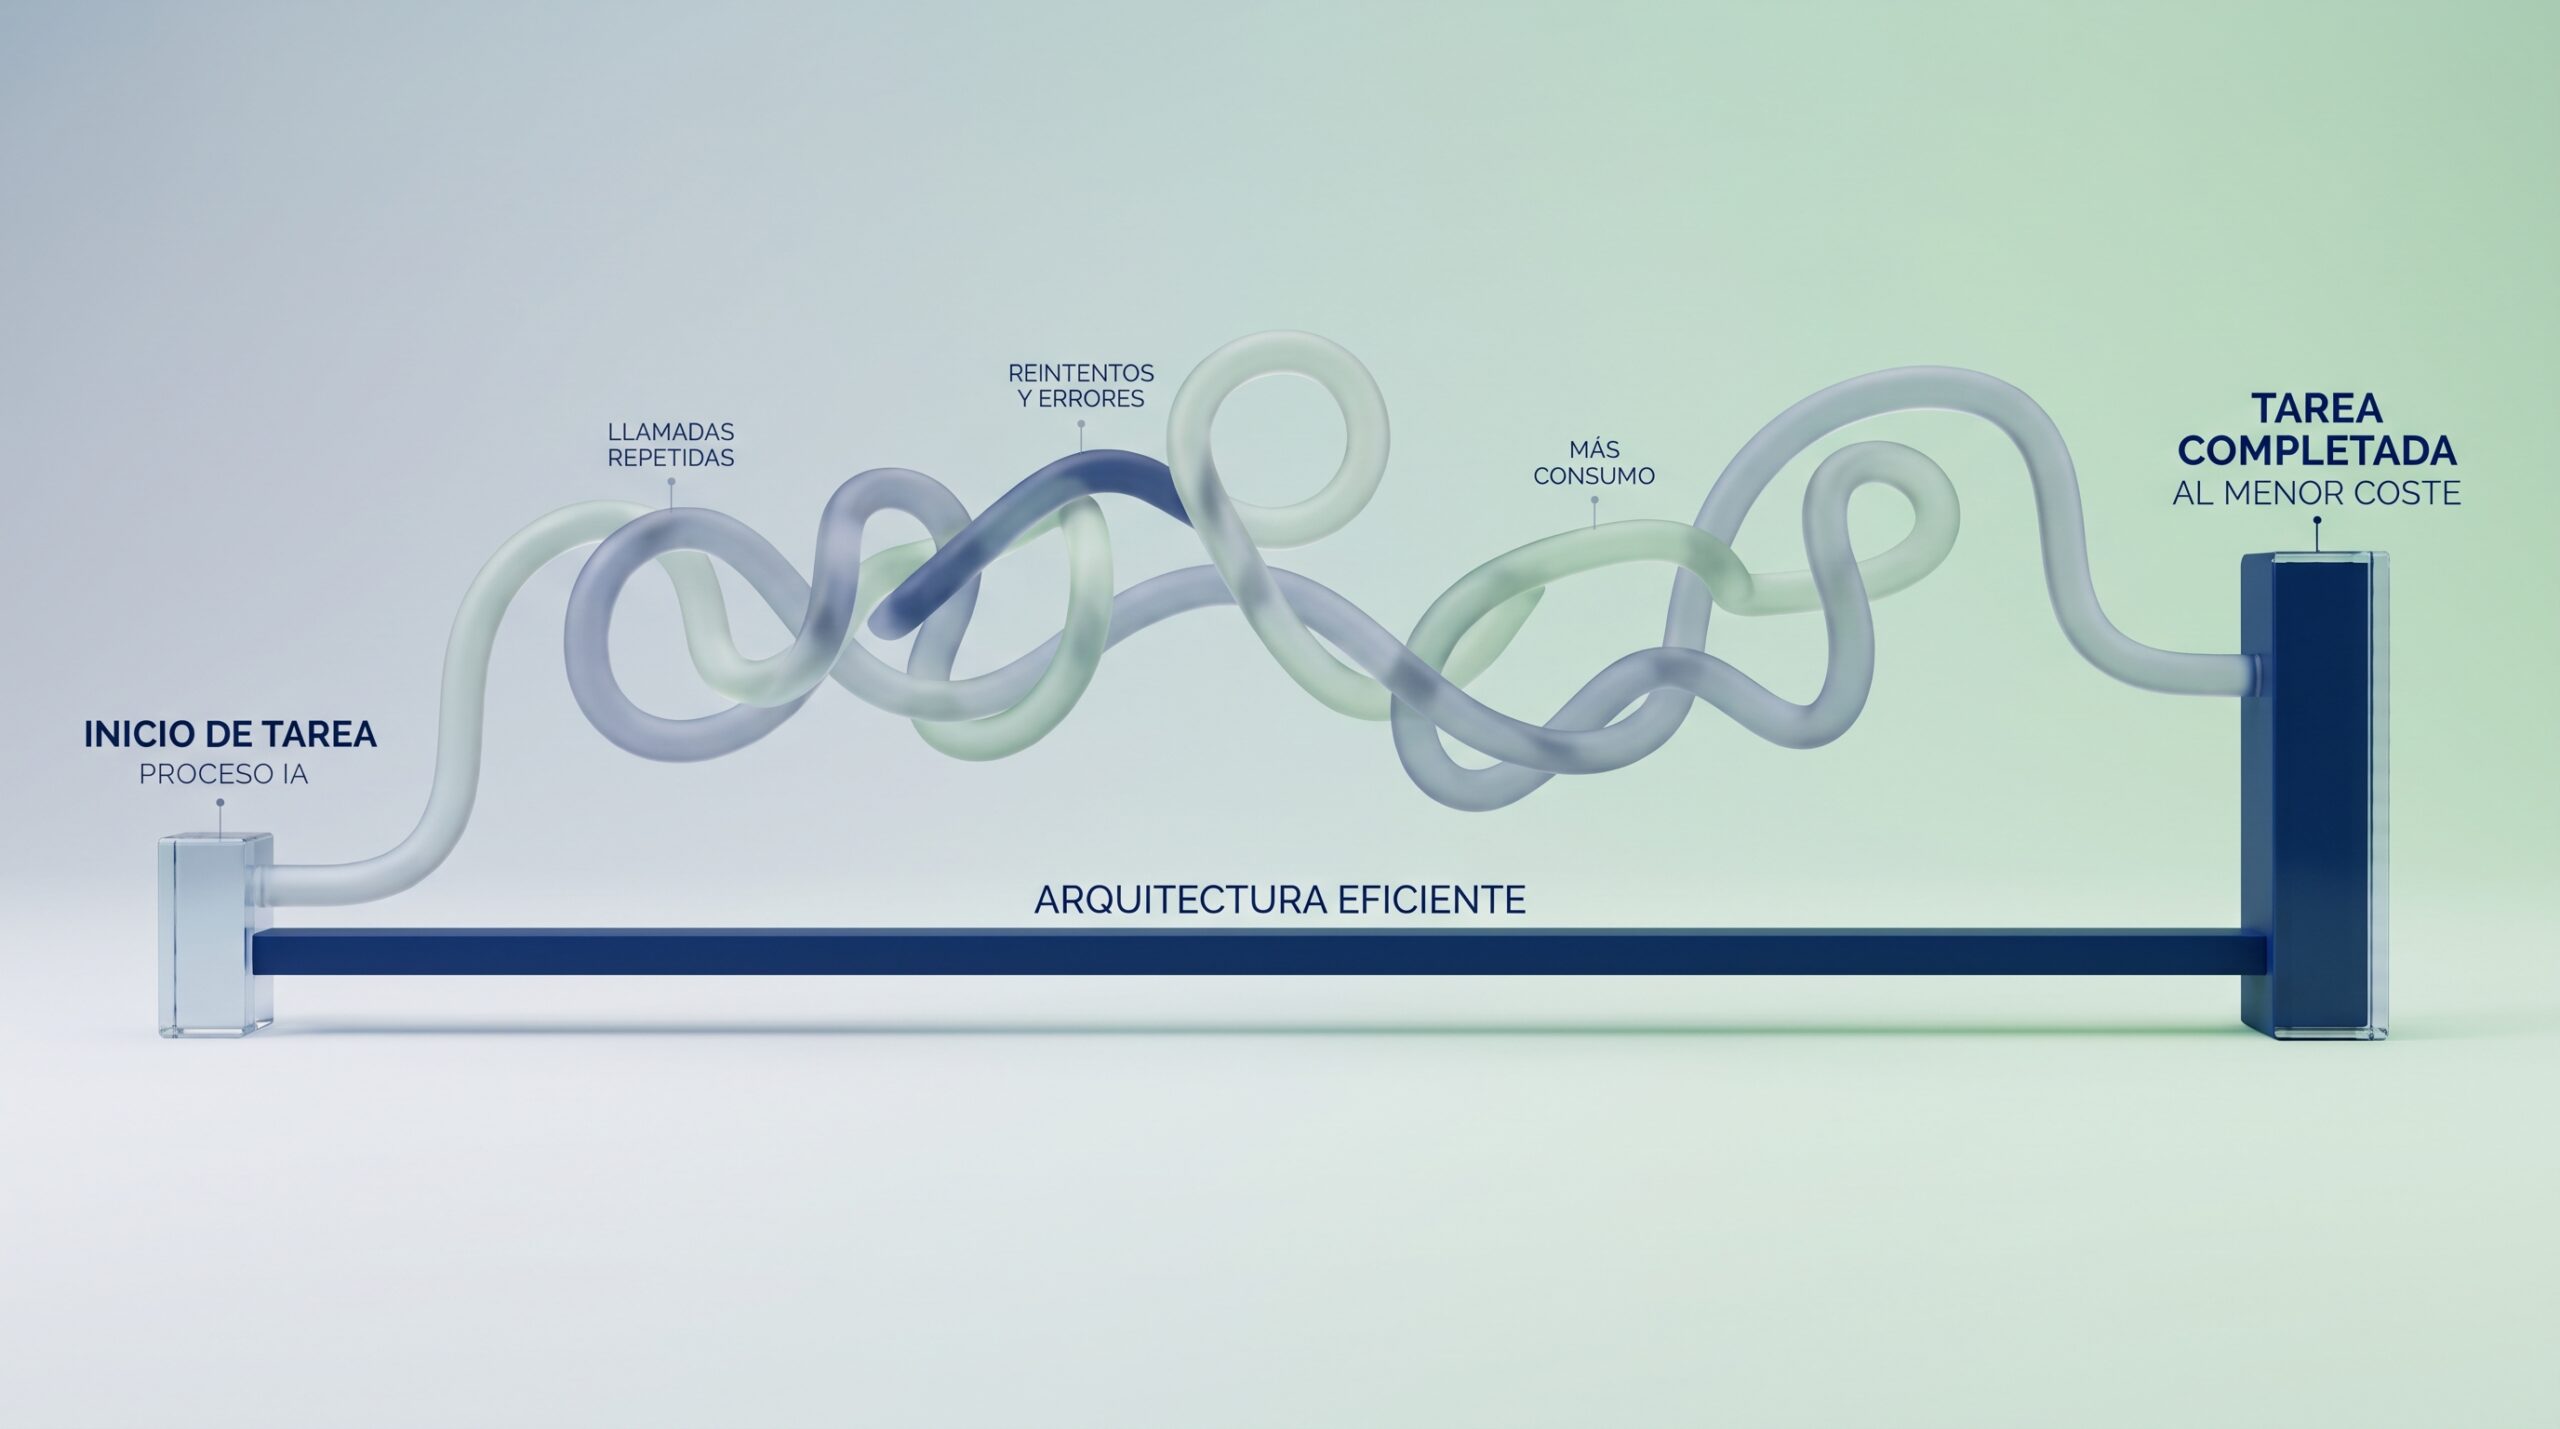
Dos aplicaciones pueden usar el mismo modelo y costar cantidades muy distintas. Una resuelve la consulta con una llamada y poco contexto. La otra recupera datos de varias fuentes, ejecuta varias operaciones, comprueba el resultado y reintenta cuando algo falla. Mismo proveedor, misma tarifa, factura muy diferente.
La diferencia está en cómo se ha diseñado la solución, cómo se conecta con los sistemas de la empresa y cuántas operaciones necesita para cerrar cada tarea. Controlar el coste de la inteligencia artificial empieza mucho antes de la primera factura.
El precio del modelo es solo una parte del coste de la inteligencia artificial
El precio por token o por llamada permite calcular el consumo, pero no el coste de la solución. A eso hay que sumarle el desarrollo, la infraestructura, las integraciones con las aplicaciones que ya están en marcha, la preparación y el gobierno de los datos, la supervisión, el mantenimiento y las horas de las personas que revisan lo que la IA produce.
Pensemos en un asistente que responde sobre el estado de un pedido, las existencias de un artículo o la situación de una orden de producción. La tarifa por consulta es baja. Pero para responder bien tiene que entender qué se le pregunta, localizar el dato en el ERP y devolverlo en una frase que sirva a quien la lee.
Si pide más datos de los que necesita, repite operaciones o no encuentra el registro correcto, el consumo sube. Y si cada respuesta acaba en la mesa de alguien que la verifica, el ahorro desaparece. La unidad que importa no es el precio de una llamada, sino el coste de completar bien la tarea.
La unidad que importa no es el precio de una llamada, sino el coste de completar bien la tarea.
La arquitectura determina cuánto cuesta cada resultado
No todas las tareas necesitan el mismo nivel de complejidad, y más sofisticación no garantiza mejor resultado. Responder por el estado de un pedido puede resolverse consultando una fuente y redactando la respuesta. Analizar una incidencia en una orden de producción es otra cosa: hay que cruzar registros, comprobar existencias, revisar al proveedor y aplicar las reglas del negocio antes de proponer una actuación.
El segundo caso puede justificar un flujo de varios pasos o un agente. La autonomía tiene sentido cuando aporta algo que no se consigue de forma más simple, y tiene un precio: cada razonamiento, cada llamada a una herramienta y cada comprobación añaden operaciones.
Gartner lo ha puesto en cifras: estima que el coste de inferencia por flujo de trabajo de IA agéntica —no de cualquier aplicación de IA— se multiplicará por más de cinco hasta 2028, y eso a pesar de que el precio por token siga bajando.
De ahí que importe tanto elegir el modelo de cada operación como diseñar el flujo. Gartner llama inference tiering a enviar cada parte del trabajo al modelo que esa parte necesita: los pasos sencillos a modelos pequeños y los que exigen razonamiento a los que lo justifican. El objetivo es el nivel de calidad que la tarea pide, al menor coste total.
Integrar bien también es una cuestión de eficiencia
En una empresa la IA no está sola. Para servir de algo necesita leer de los sistemas que ya están funcionando —el ERP, el CRM— y, cuando toca, operar sobre ellos. Y la forma de hacer esa conexión decide buena parte del rendimiento: una integración bien planteada recupera solo lo que necesita, respeta los permisos que ya existen y no repite consultas que ya ha hecho.
El asistente de pedidos del ejemplo anterior lo nota enseguida: si cada interacción le llega cargada de datos que no ha pedido, no solo procesa más contexto, también le cuesta más encontrar el dato que importa. Esto obliga a trabajar la integración y, antes que eso, la organización de los datos.
Y obliga a decidir tres cosas por escrito: qué puede consultar la IA, qué acciones tiene permitido ejecutar y en qué casos debe parar y pedir una validación humana. Los permisos de cada persona tienen que seguir valiendo cuando pregunta a través de la IA, y cada operación debe quedar registrada. Esto condiciona la seguridad, pero también el mantenimiento: una solución cuyas operaciones no se pueden auditar es una solución que nadie se atreve a cambiar.
Una solución cuyas operaciones no se pueden auditar es una solución que nadie se atreve a cambiar.
Medir el rendimiento más allá del consumo
Reducir el gasto en tokens es útil, pero como objetivo es engañoso. Una optimización que abarata cada llamada y a la vez multiplica los errores o los reintentos termina saliendo más cara.
Los indicadores se fijan en el diseño, no cuando llega la factura:
- Coste por tarea completada correctamente — lo que cuesta un resultado utilizable, no una llamada.
- Casos resueltos sin intervención humana — el porcentaje que no acaba en la mesa de alguien.
- Tiempo medio de ejecución — lo que tarda en cerrar la tarea, no en empezar a responder.
- Tasa de errores — cuántos resultados hay que corregir o repetir.
- Operaciones por proceso — cuántas llamadas y consultas necesita cada tarea.
Con estos números se pueden comparar alternativas con criterio técnico. Un modelo más caro por llamada puede resultar el más barato del conjunto si acierta a la primera y no necesita que nadie lo revise.
Un modelo más caro por llamada puede resultar el más barato si acierta a la primera.
Y esto no se mide una vez. Una solución de IA no está terminada el día que arranca: cambian los volúmenes, aparecen casos que nadie había previsto y la arquitectura que servía para dos consultas al día puede no servir para cien. Revisar el contexto que se envía al modelo y las llamadas que se repiten sin aportar nada suele dar margen, siempre que se compruebe que el recorte no se lleva por delante la calidad de las respuestas.


IÑIGO GOIKOETXEA y GORKA ALDASORO
Iñigo es especialista en IA y Ciencia de Datos, y Gorka en desarrollo de proyectos con IA, en ANASINF.