
Una empresa de distribución quiere conectar una herramienta nueva y lo primero que hay que abrir es el fichero de clientes. Ahí aparece el mismo cliente tres veces. Una con la razón social completa, otra con el nombre comercial y otra con una abreviatura que alguien tecleó con prisa un viernes por la tarde. Existe en el ERP porque se le factura, en el CRM porque alguien lo visitó cuando todavía era un contacto y en la herramienta de soporte porque abrió una incidencia hace dos años.
Nadie hizo nada mal. Cada uno de esos sistemas se implantó para resolver un problema distinto, en un momento distinto, y ninguno tenía por qué saber de la existencia de los otros. Lo llamativo es lo que pasa el día que alguien pregunta cuánto se le ha vendido a ese cliente. La respuesta tarda dos horas y sigue sin ser del todo cierta.
Ese cliente por triplicado es el gobierno del dato visto desde dentro. La expresión nos gusta poco, porque suena a comité y a documento largo, pero lo que hay detrás es bastante concreto. Son piezas que se construyen encima de los sistemas que la empresa ya tiene. Y ninguna funciona si antes nadie ha dicho qué se considera un cliente en esta empresa. Se puede levantar el circuito entero y, sin esa decisión tomada, lo que se consigue es repartir el desorden con más eficiencia.
Cómo se llega a tener tres clientes donde hay uno
Nadie decide duplicar un maestro. Se duplica porque el sistema que llegó segundo necesitaba su propio fichero para poder arrancar, y montar la equivalencia con el primero costaba tres semanas que en aquel momento no había. Mientras la empresa es pequeña no se nota, porque siempre hay alguien que conoce las equivalencias de memoria.
Lo que hace más daño no es la duplicidad, es lo otro. Los campos que significan cosas distintas según dónde se miren. La fecha de pedido puede ser el día que el cliente dijo que sí, el día que se firmó el presupuesto o el día que entró en producción. Las tres son defendibles. Las tres están bien puestas. Y producen tres cifras de ventas del mes que no coinciden, con la consecuencia de siempre, que la conversación se desvía hacia quién ha calculado mal en lugar de ir hacia qué se está midiendo.
Después está todo lo que se acaba haciendo a mano porque el sistema no lo cubría. Una exportación a hoja de cálculo que alguien complementa con un par de columnas, comparte por correo y termina siendo el de referencia de un área entera. Esa hoja ya no vuelve a ningún sitio. Envejece a su ritmo y nadie sabe en qué momento dejó de estar actualizada.
Y está la capa de informes construida tirando directamente contra la base de datos de una aplicación, sin pasar por ningún punto común. Cada informe hereda el criterio de la aplicación sobre la que se montó. Ese criterio existe, funciona razonablemente bien y no está escrito en ninguna parte.
Lo que hay debajo de un dato en el que se puede confiar
Volvamos al cliente triplicado. Para que deje de estarlo hacen falta cinco cosas, y ninguna viene de serie:
1. Decidir qué sistema manda sobre cada entidad:
Si el ERP manda sobre el cliente, el CRM lee de él y no crea fichas por su cuenta. Suena obvio hasta que uno mira cómo se da de alta un cliente potencial que todavía no tiene datos fiscales, que es justo el hueco por donde entran los duplicados.
2. Escribir en algún sitio qué significa cada cosa:
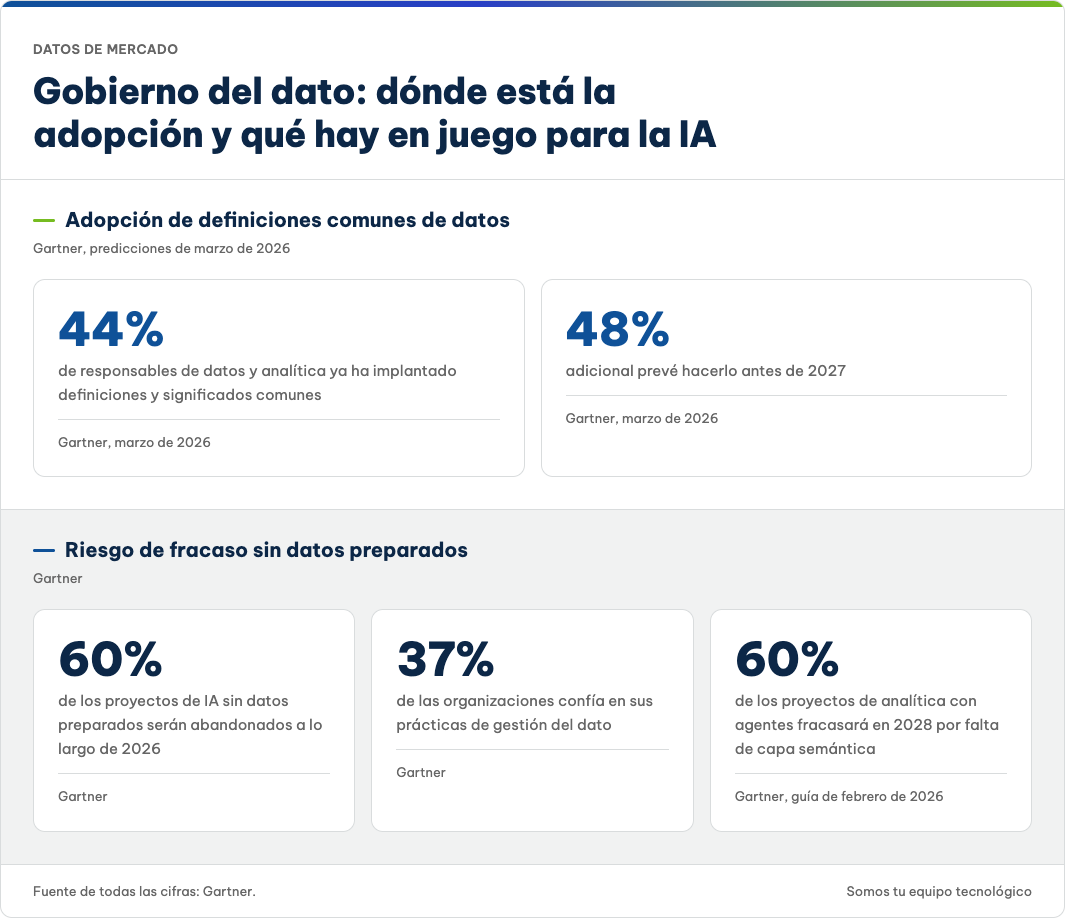
Esta pieza ha cambiado de categoría en el último año. En sus predicciones de marzo de 2026, Gartner señala que las empresas necesitan organizar sus datos con definiciones y significados comunes para poder utilizarlos de forma fiable con la inteligencia artificial. Por eso, recomienda considerar esta capacidad como una parte básica de la infraestructura tecnológica. Del mismo encuentro salió el dato de adopción, con un 44% de responsables de datos y analítica que ya la ha implantado y un 48% adicional que prevé hacerlo antes de 2027. Traducido a la empresa de la que hablábamos, el criterio de qué entra dentro del margen deja de vivir en la cabeza de quien monta el informe y pasa a estar en un sitio del que leen todas las herramientas.
3. El rastro de los cambios:
Cuando una cifra baila entre dos consultas hechas con una semana de diferencia, hace falta poder ver qué registro se tocó, cuándo y desde dónde. Sin ese rastro, cada discrepancia se investiga desde cero y cuesta una mañana de trabajo de alguien.
4. Quién puede mirar y quién puede modificar:
Lo que se protege aquí no es solo la confidencialidad. Es la integridad de los maestros frente a correcciones bienintencionadas hechas en el sitio equivocado, que es una de las formas más habituales de romper un dato que estaba limpio.
5. El punto desde el que se informa:
Una capa que recoge de los sistemas de origen, aplica las definiciones acordadas y entrega una sola versión. Cuando existe, un cuadro de mando deja de ser una interpretación y pasa a ser una lectura.
Sobre estas cinco piezas conviene decir algo que se olvida a menudo. No se activan, se construyen, y después hay que mantenerlas. Un maestro sin nadie que lo revise vuelve a duplicarse en menos de un año. Una definición que no se actualiza cuando cambia el modelo de negocio se convierte en una mentira muy bien calculada.
La pregunta que no tiene respuesta técnica
Todo lo anterior necesita una entrada que no sale de ningún sistema. Necesita que alguien haya dicho qué es un cliente activo, qué cuenta como venta cerrada y qué entra dentro del coste de un proyecto. Eso no es un dato. Es un acuerdo, y es donde nos paramos siempre.
Es un acuerdo, y es donde nos paramos siempre.
Podemos diseñar el circuito, proponer el criterio a partir de cómo funciona el negocio y sostenerlo durante años. Lo que no podemos hacer es validar qué significa cada cosa, porque esa decisión define sobre qué información se va a gobernar la empresa a partir de entonces. Y aquí viene la parte incómoda. El mecanismo se construye igual sin esa validación. Un circuito impecable alimentado por definiciones que nadie ha confirmado reparte, con toda la trazabilidad del mundo, información en la que nadie acaba de confiar.
Eso no es un dato. Es un acuerdo.
Hay una frontera entre lo que decide dirección y lo que decide sistemas. Merece una conversación propia y la tendremos. De momento basta con saber que está ahí y que no la cruza la tecnología sola.
Si este tema te interesa más desde el lado de la decisión que desde el de la construcción, en MIT KORE lo contamos en por qué una pyme puede tener muchos datos y aun así no decidir con ellos.
Lo que aguanta encima de una base ordenada
Ordenar el dato no es un fin en sí mismo. Es lo que hace que lo siguiente no empiece de cero.
Con los maestros ordenados y una capa de consolidación funcionando, meter un sistema nuevo deja de obligar a rehacer las integraciones que ya había, porque el sistema nuevo se conecta contra un punto conocido en lugar de contra cinco aplicaciones a la vez. Automatizar deja de dar miedo, porque una automatización que se dispara con un criterio ambiguo propaga el error exactamente a la velocidad a la que se ejecuta.
Un agente escribe la consulta sin problema. Lo que no puede es decidir qué significa margen en esta empresa.
Y es la condición para cualquier proyecto de inteligencia artificial que aspire a salir del piloto. Gartner calcula que a lo largo de 2026 las organizaciones abandonarán el 60% de los proyectos de IA que no cuenten con datos preparados para ese uso, y sitúa en un 37% las que tienen confianza en sus prácticas de gestión del dato. El matiz técnico importa más de lo que parece. Un dato preparado para IA es más exigente que un dato preparado para informar, porque pide calidad continua y rastro de origen al ritmo al que el modelo consume la información, no al ritmo mensual al que se cierran los informes. En su guía de febrero de 2026, la misma consultora prevé que para 2028 fracase el 60% de los proyectos de analítica con agentes que se apoyen solo en el protocolo de conexión con los sistemas, por no tener una capa semántica consistente. Un agente escribe la consulta sin problema. Lo que no puede es decidir qué significa margen en esta empresa.
De ese salto del piloto a la producción ya escribimos con detalle en por qué la mayoría de los agentes de IA en la pyme fracasa antes de empezar.
Una comprobación de veinte minutos
Si quieres saber si esto le pasa a tu empresa, hay una prueba que no requiere tocar nada. Coge un indicador que se mire cada semana. Pregunta a dos áreas distintas de dónde sacan ese número y qué incluyen dentro. Si las respuestas no coinciden del todo, ya tienes el punto de partida, y no está en ninguna herramienta que haya que comprar. Está en una definición que todavía no ha escrito nadie.


IÑIGO GOIKOETXEA y SUSANA RODRIGUEZ
Iñigo y Susana son especialistas en IA y Ciencia de Datos y en análisis y desarrollo de proyectos,
respectivamente, en ANASINF.
Entradas relacionadas

6 Mins de lectura
En una reunión de dirección alguien pregunta cuántos sistemas de la empresa usan...

7 Mins de lectura
Una pyme industrial decide pilotar un agente de IA para gestionar las incidencias de soporte...
5 Mins de lectura
Esta semana asistimos al III Summit de Análisis de Datos: […]

1 Mins de lectura
En Anasinf, la seguridad de los datos, es una prioridad. […]

2 Mins de lectura
Hoy he tenido el placer de asistir a una charla […]
4 Mins de lectura
En Anasinf apoyamos el desarrollo del talento en el sector […]

3 Mins de lectura
Bajo el nombre de la antigua diosa griega de la […]
3 Mins de lectura
El jueves pasado, tuve el placer de sumergirme en el […]

4 Mins de lectura
Hoy es el Día Mundial de la Usabilidad, una ocasión […]

2 Mins de lectura
En esta era digital, la sostenibilidad tecnológica es un concepto […]

4 Mins de lectura
Como técnico de sistemas en nuestra empresa, Anasinf, a menudo […]


